Un dirigeant nous pose souvent la même question, avec des mots différents. Il veut que « l’IA » travaille avec son site. Parfois il a vu une démo. Parfois on lui a promis que le site serait « branché sur ChatGPT ». La question utile n’est pas le nom de l’assistant. C’est ce que le site donne à lire, et ce qu’il autorise à faire.
Chez Trois Cent Un, nous appelons ça un site IA Ready. Ce n’est pas un label vendu par un éditeur. Nous n’avons pas de partenariat avec OpenAI, Anthropic, Google ou xAI. ChatGPT, Claude, Gemini et Grok sont des produits publics. Leurs éditeurs publient une documentation, que nous lisons comme n’importe quel prestataire : OpenAI, Anthropic, Google, xAI. Un site IA Ready est une façon de construire, pour qu’un assistant puisse s’appuyer sur ce qui est écrit, au lieu de compléter dans le vide.
Quatre choses suffisent à l’expliquer à une PME. Aucune ne demande de devenir technicien.
Un contenu qu’on peut citer
Un assistant répond à partir de ce qu’il trouve. Si la page dit qui vous êtes, ce que vous faites, pour qui, et comment vous joindre, il a une matière. Si la page est un bloc de slogans, il comble les trous. Nous écrivons donc des pages avec des titres nets, une idée par section, et les faits au même endroit. Le nom, la ville, l’offre, la façon de nous écrire. Rouen et la Normandie y figurent parce que c’est notre ancrage, pas parce qu’un champ de formulaire le réclame.
Ce travail est le plus ingrat, et le plus utile. Il sert le visiteur avant de servir la machine. Un dirigeant qui ne retrouve pas l’offre en quelques phrases ne la fera pas retrouver à un assistant. Nous commençons par là, avant de parler de connecteur.
Concrètement, sur une page d’offre, nous voulons pouvoir répondre à voix haute à quatre questions. Qui parle. Ce qui est vendu. À qui cela s’adresse. Ce qui n’est pas vendu. Si l’une des quatre réponses est absente, la page n’est pas prête, quel que soit l’outil qui l’affiche.
Des données structurées, sans les remplir au hasard
À côté du texte, on publie un bloc que les machines savent parcourir. Le vocabulaire public s’appelle schema.org. Le guide de démarrage pose le principe : décrire des choses, avec des types partagés, plutôt que d’espérer qu’un lecteur devine la structure d’une page.
Nous nous en tenons à trois types, ceux qui décrivent une entreprise locale sans exiger un chiffre.
Organization dit qui publie le site. LocalBusiness précise qu’il s’agit d’une activité située. Service décrit une prestation : un nom, une phrase, l’adresse de la page. Sur trois-cent-un.fr, ces blocs sont dans le code des pages d’offre. On peut les afficher, les comparer au texte, et voir s’ils disent la même chose.
Nous ne mettons dans ce bloc que ce qui est déjà public. La ville, oui. Une rue que nous n’avons pas publiée ailleurs, non. Un avis, une note, une heure d’ouverture, non plus, tant que ces informations ne sont pas affichées en clair sur le site. Un champ vide ou inventé ne rend pas le site plus « intelligent ». Il le rend moins fiable. C’est pour cela que l’adresse postale complète n’apparaît pas dans nos données structurées : nous ne l’avons pas publiée.
Le contrôle est à la portée d’un dirigeant. Ouvrir la page. Afficher le code source, ou passer l’adresse dans le test des résultats enrichis que Google publie. Lire le nom, la ville, les prestations. Si le bloc contredit la page, c’est le bloc qu’il faut corriger, pas le discours commercial.
Un fichier llms.txt
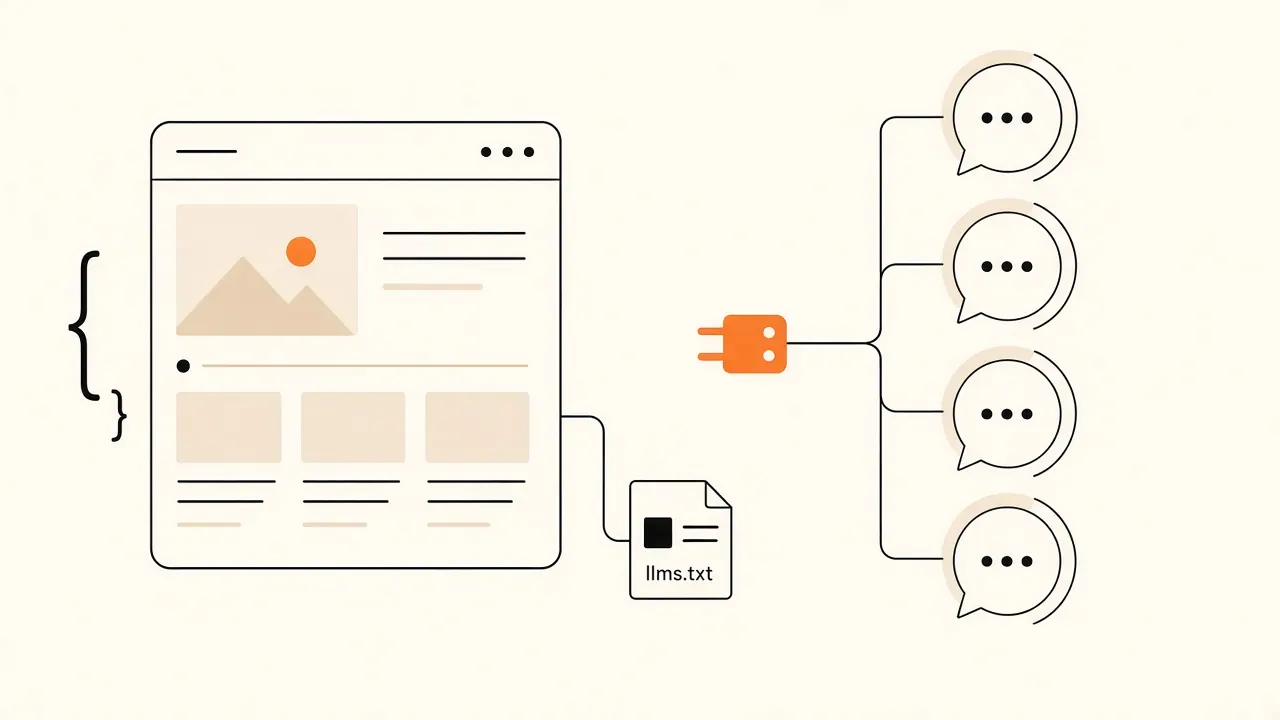
llms.txt est une proposition publique. L’idée tient en peu de mots. À la racine du site, un fichier texte résume l’activité et pointe vers les pages qui comptent. Ce n’est pas une place achetée dans un assistant. Ce n’est pas un classement. C’est une page d’accueil écrite pour une machine, courte, que l’on met à jour quand l’offre change.
Le nôtre est à l’adresse /llms.txt. Il dit ce que nous faisons, ce que nous ne faisons plus, et les pages à lire. Il dit aussi une limite, volontaire. Aucun connecteur n’est ouvert sur ce site pour agir à la place du visiteur. Le formulaire de contact reste le geste humain. Nous préférons l’écrire dans le fichier plutôt que de laisser un assistant le supposer.
Tenir ce fichier est un travail d’édition, pas d’infrastructure. Quand une phrase de l’offre change sur le site, elle change dans le fichier. Sinon le résumé ment, et un assistant qui s’y fie répète une offre périmée. Nous le traitons comme une page : relu, daté dans notre tête au moment où l’offre bouge, et assez court pour qu’on voie tout de suite ce qui est faux.
Le format décrit sur llmstxt.org est du texte simple, avec un titre, un résumé, puis des liens. Nous n’y ajoutons pas de promesse que la spécification ne contient pas. Un fichier présent ne signifie pas qu’un assistant l’a lu. Il signifie que, s’il le demande, il trouve une version courte et à jour.
Une porte, seulement s’il y a une action
Lire suffit souvent. L’offre, la ville, l’adresse d’un formulaire. Agir, c’est autre chose. Déposer une demande, lire un créneau, préparer un devis. Pour cela, il faut une action prévue à l’avance. Deux mots nous servent avec les dirigeants, et nous les distinguons.
Une API est une adresse prévue pour qu’un programme lise ou écrive une information précise. On sait ce qui entre, ce qui sort, et qui a le droit d’appeler. Un connecteur MCP va dans le même sens, avec un vocabulaire pensé pour les assistants. MCP, Model Context Protocol, est une spécification publique, présentée sur modelcontextprotocol.io. En une phrase : l’assistant appelle une liste d’actions autorisées. Chaque action dit ce qu’elle a le droit de faire.
Ce n’est pas « l’assistant a les clés de l’entreprise ». C’est une porte, et la liste de ce qui peut la franchir. Nous n’ouvrons cette porte que s’il y a un geste utile. Beaucoup de sites n’en ont pas besoin le jour de la mise en ligne. Le dire fait partie du travail. Ajouter un connecteur pour une démonstration, sans action réelle, crée une surface à surveiller, et rien à montrer au dirigeant.
Sur notre propre site, cette porte n’est pas ouverte. Le fichier llms.txt le dit. Le visiteur écrit par le formulaire. Nous ne publierons pas un article de journal de chantier sur « une action MCP » tant que cette action n’existera pas vraiment, avec ce qu’elle autorise et ce qu’elle refuse.
Ce que nous vérifions avant de prononcer les mots
Sur un site que nous livrons, nous vérifions trois choses avant de parler d’IA Ready.
Le texte des pages principales peut être cité sans le réécrire. Le bloc schema.org correspond à ce texte, sans champ en trop. Le fichier llms.txt pointe vers ces pages, et vers rien qui ne soit plus à l’offre.
Nous ne promettons pas que ChatGPT, Claude, Gemini ou Grok citeront le site. Leur façon de répondre leur appartient, et elle change sans nous prévenir. Nous ne promettons pas une place, ni un trafic, ni une réponse exacte à chaque question d’un prospect. Nous promettons une matière claire. Si une action existe, nous promettons une permission bornée, écrite, que l’on peut retirer.
Le contrôle, du côté du dirigeant, reste simple. Ouvrir la page et la lire comme un client pressé. Ouvrir /llms.txt et voir si le résumé est encore vrai. Demander à quelqu’un du métier si l’offre est reconnaissable. Si la réponse est non, aucun connecteur ne réparera la page.
Nous construisons ces sites avec Astro ou avec Nuxt. Le choix entre les deux se fait avant le devis, selon que le site est un ensemble de pages ou une application. C’est l’objet d’un autre texte. Ici, la seule question est celle-ci : est-ce qu’un assistant peut s’appuyer sur le site sans inventer l’entreprise.